Análise exploratória de dados (EDA)
Antes de construir recursos ou modelos de previsão de treinamento, devemos explorar o conjunto de dados para entender suas características, descobrir padrões de demanda horária / diária e detectar anomalias.
Neste caderno, analisamos os históricos logs de coleta NYC Yellow Taxi agrupados por hora e zona de localização.
import matplotlib.pyplot as plt
import pandas as pd

# Load the preprocessed dataset
dataset_path = "../data/processed/training_dataset.parquet"
df = pd.read_parquet(dataset_path)

print(f"Dataset shape: {df.shape}")
print("Columns:", list(df.columns))
df.head()
Dataset shape: (71253, 8)
Columns: ['pickup_location_id', 'pickup_hour', 'pickup_count', 'hour', 'day_of_week', 'is_weekend', 'month', 'next_hour_pickup_count']
| pickup_location_id | pickup_hour | pickup_count | hour | day_of_week | is_weekend | month | next_hour_pickup_count | |
|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 2022-10-24 17:00:00 | 1 | 17 | 0 | False | 10 | 1 |
| 1 | 1 | 2022-10-25 03:00:00 | 1 | 3 | 1 | False | 10 | 1 |
| 2 | 1 | 2023-01-01 05:00:00 | 1 | 5 | 6 | True | 1 | 1 |
| 3 | 1 | 2023-01-01 08:00:00 | 1 | 8 | 6 | True | 1 | 1 |
| 4 | 1 | 2023-01-01 11:00:00 | 1 | 11 | 6 | True | 1 | 3 |
Sumário Estatísticas
Vejamos as estatísticas básicas de nossos dados de demanda, especialmente a coluna de destino next_hour_pickup_count.
df["next_hour_pickup_count"].describe()
count    71253.000000
mean        42.985530
std         73.051339
min          1.000000
25%          1.000000
50%          7.000000
75%         55.000000
max        699.000000
Name: next_hour_pickup_count, dtype: float64
Distribuição Variável Alvo e Características Estatísticas
Vamos visualizar a distribuição da demanda de coleta de próxima hora em todas as zonas. A demanda de táxi amarelo normalmente exibe duas características estatísticas principais:
- Sparsity & Inflação Zero: Uma proporção significativa de horas em zonas residenciais ou remotas tem exatamente 0 embarques.
- Sobredispersão: A variância da contagem de captação é muito maior do que sua média (). Modelos de contagem padrão como regressão de Poisson assumem média variância; uma vez que isso é violado, modelos lineares L2-regularizados são preferidos para evitar overfitting sobre o ruído de zonas de alta variação.
mean_demand = df["next_hour_pickup_count"].mean()
var_demand = df["next_hour_pickup_count"].var()

plt.figure(figsize=(10, 5))
plt.hist(
    df["next_hour_pickup_count"],
    bins=50,
    color="#1f77b4",
    edgecolor="black",
    alpha=0.7,
)
plt.axvline(
    mean_demand,
    color="red",
    linestyle="dashed",
    linewidth=2,
    label=f"Mean: {mean_demand:.2f}",
)
plt.title("Distribution of Next-Hour Taxi Demand", fontsize=14)
plt.xlabel("Demand (Ride Count)", fontsize=12)
plt.ylabel("Frequency", fontsize=12)
plt.legend(fontsize=11)
plt.grid(True, alpha=0.3)
plt.show()

print(f"Target Mean (mu): {mean_demand:.2f}")
print(f"Target Variance (sigma^2): {var_demand:.2f}")
print(f"Overdispersion Ratio (sigma^2 / mu): {var_demand / mean_demand:.2f}")
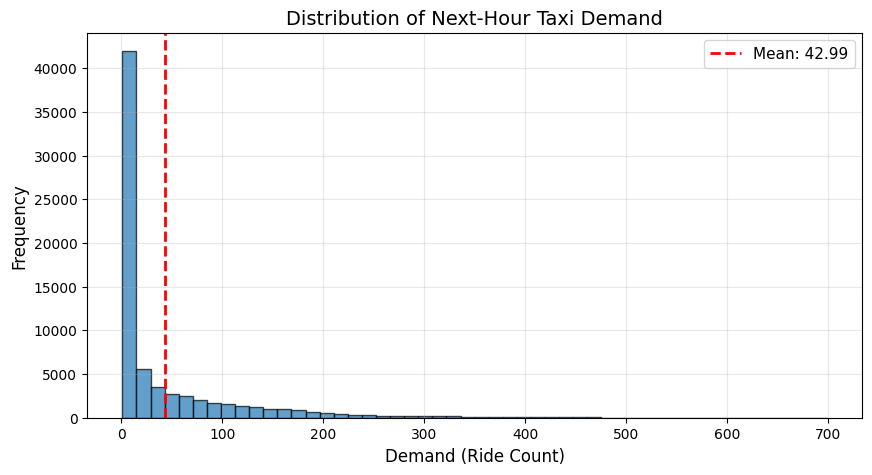
Target Mean (mu): 42.99
Target Variance (sigma^2): 5336.50
Overdispersion Ratio (sigma^2 / mu): 124.15
Perfis horários e diários
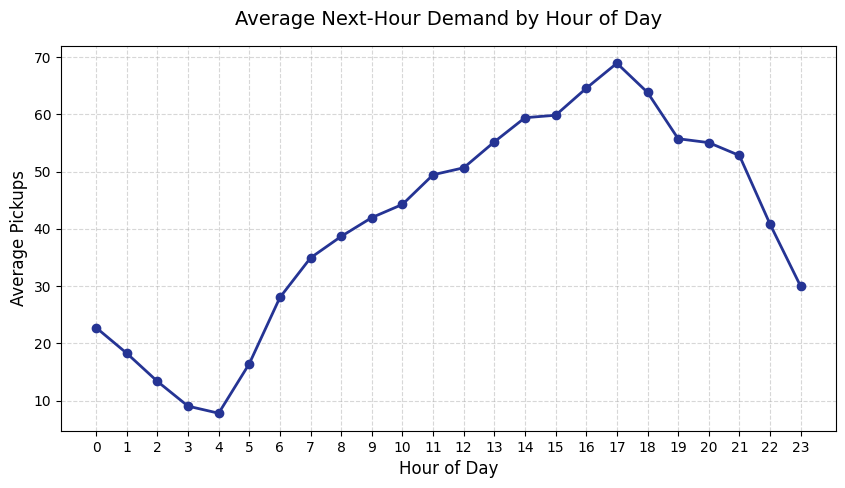
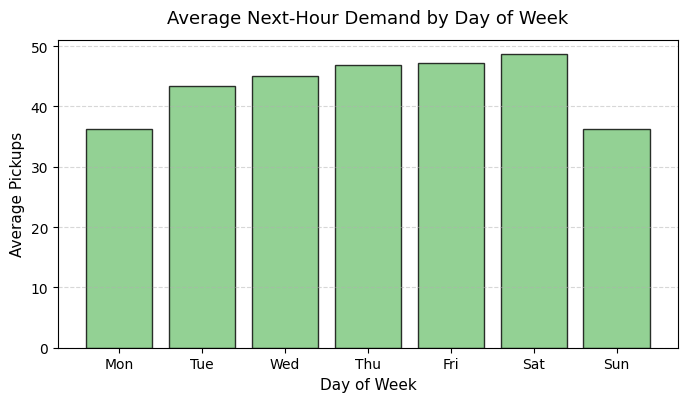
Vamos inspecionar como a demanda varia por hora do dia e dia da semana. A demanda de táxi amarelo normalmente tem fortes padrões diurnos e aumenta durante o horário de pico da noite.
# Extract hour and day of week
df["pickup_hour"] = pd.to_datetime(df["pickup_hour"])
df["hour"] = df["pickup_hour"].dt.hour
df["day_of_week"] = df["pickup_hour"].dt.dayofweek

# Average pickups by hour
hourly_demand = df.groupby("hour")["next_hour_pickup_count"].mean()
plt.figure(figsize=(10, 5))
plt.plot(
    hourly_demand.index,
    hourly_demand.values,
    marker="o",
    color="#253494",
    linewidth=2,
)
plt.title("Average Next-Hour Demand by Hour of Day", fontsize=14, pad=15)
plt.xlabel("Hour of Day", fontsize=12)
plt.ylabel("Average Pickups", fontsize=12)
plt.xticks(range(24))
plt.grid(True, linestyle="--", alpha=0.5)
plt.show()

# Average pickups by day of week
weekly_demand = df.groupby("day_of_week")["next_hour_pickup_count"].mean()
days = ["Mon", "Tue", "Wed", "Thu", "Fri", "Sat", "Sun"]
plt.figure(figsize=(8, 4))
plt.bar(
    days, weekly_demand.values, color="#78c679", edgecolor="black", alpha=0.8
)
plt.title("Average Next-Hour Demand by Day of Week", fontsize=13, pad=12)
plt.xlabel("Day of Week", fontsize=11)
plt.ylabel("Average Pickups", fontsize=11)
plt.grid(axis="y", linestyle="--", alpha=0.5)
plt.show()
Análise de Autocorrelação Temporal
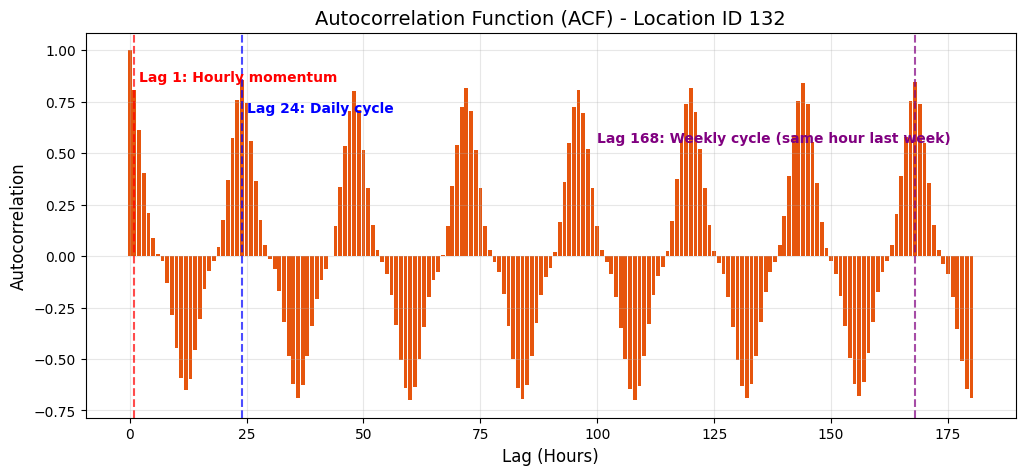
Para justificar o uso de lags históricos em nossos modelos e modelos Feature Store, analisamos o Função de Autocorrelação (ACF). O ACF mede a correlação da série de tempo de demanda consigo mesmo em diferentes lag temporais (em horas).
# Select the most active zone to see a clean seasonal signal
active_zone = df["pickup_location_id"].value_counts().index[0]
zone_df = df[df["pickup_location_id"] == active_zone].sort_values(
    "pickup_hour"
)
series = zone_df["next_hour_pickup_count"]

lags = 180
acf_vals = [series.autocorr(lag=i) for i in range(lags + 1)]

plt.figure(figsize=(12, 5))
plt.bar(
    range(lags + 1),
    acf_vals,
    color="#e6550d",
    width=0.8,
    edgecolor="none",
)

# Add dashed lines for key lags
plt.axvline(1, color="red", linestyle="--", alpha=0.7)
plt.axvline(24, color="blue", linestyle="--", alpha=0.7)
plt.axvline(168, color="purple", linestyle="--", alpha=0.7)

# Add annotations
plt.text(
    2,
    0.85,
    "Lag 1: Hourly momentum",
    color="red",
    fontsize=10,
    fontweight="bold",
)
plt.text(
    25,
    0.70,
    "Lag 24: Daily cycle",
    color="blue",
    fontsize=10,
    fontweight="bold",
)
plt.text(
    100,
    0.55,
    "Lag 168: Weekly cycle (same hour last week)",
    color="purple",
    fontsize=10,
    fontweight="bold",
)

plt.title(
    "Autocorrelation Function (ACF) - Location ID " + str(active_zone),
    fontsize=14,
)
plt.xlabel("Lag (Hours)", fontsize=12)
plt.ylabel("Autocorrelation", fontsize=12)
plt.grid(True, alpha=0.3)
plt.show()