Engenharia de Features
Um grande gargalo na produção ML é treinamento-serving sketcha discrepância entre como os recursos são calculados durante o treinamento do modelo versus como eles são consultados no momento da inferência. Para resolver isso, usamos Feast como nosso Feature Store.
Conceitos chave Feast neste projeto
- Entidade: A chave primária. Aqui, o
pickup_location_idrepresenta uma zona de táxi. - Fonte de dados: A fonte da verdade para características. Definimos uma fonte de arquivo em lote apontando para o nosso arquivo de parquet off-line:
data/processed/hourly_demand_features.parquet. - Característica Ver: Mapas recursos para entidades e define metadados (esquema, TTL e fonte de dados).
Offline & Lojas Online
Feast lida com duas bases de dados sob o capô:
- Loja offline (DuckDB): Otimizado para consultas analíticas. Usado durante o treinamento para executar Point-in-Time se junta e recuperar registros históricos de recursos.
- Loja Online (SQLite): Otimizado para pesquisas rápidas e de baixa latência. Recursos materializados são carregados aqui para previsões em tempo real.
import ipywidgets as widgets
import matplotlib.pyplot as plt
import pandas as pd

# Load feature data from the processed parquet destination
features_path = "../data/processed/hourly_demand_features.parquet"
df = pd.read_parquet(features_path)
df["event_timestamp"] = pd.to_datetime(df["event_timestamp"])
print(f"Loaded {len(df)} feature rows. Columns:")
df.head()
Stream
Loaded 71253 feature rows. Columns:
| pickup_location_id | event_timestamp | pickup_count | hour | day_of_week | is_weekend | month | |
|---|---|---|---|---|---|---|---|
| 0 | 1 | 2022-10-24 17:00:00 | 1 | 17 | 0 | False | 10 |
| 1 | 1 | 2022-10-25 03:00:00 | 1 | 3 | 1 | False | 10 |
| 2 | 1 | 2023-01-01 05:00:00 | 1 | 5 | 6 | True | 1 |
| 3 | 1 | 2023-01-01 08:00:00 | 1 | 8 | 6 | True | 1 |
| 4 | 1 | 2023-01-01 11:00:00 | 1 | 11 | 6 | True | 1 |
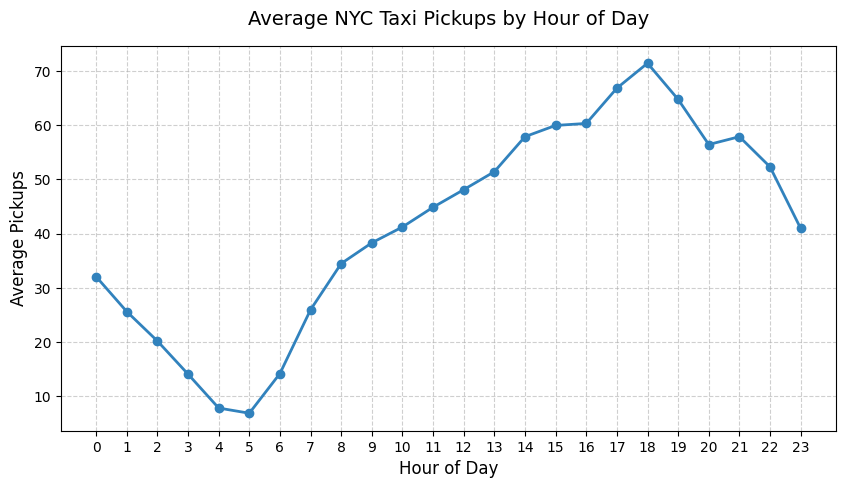
Visualize as captações de táxi ao longo do tempo
Vamos olhar para a curva de demanda média ao longo de horas do dia.
hourly_avg = df.groupby("hour")["pickup_count"].mean()

plt.figure(figsize=(10, 5))
plt.plot(
    hourly_avg.index,
    hourly_avg.values,
    marker="o",
    color="#3182bd",
    linewidth=2,
)
plt.title("Average NYC Taxi Pickups by Hour of Day", fontsize=14, pad=15)
plt.xlabel("Hour of Day", fontsize=12)
plt.ylabel("Average Pickups", fontsize=12)
plt.grid(True, linestyle="--", alpha=0.6)
plt.xticks(range(24))
plt.show()
Explorador de Zona Interativa
Use este widget interativo para inspecionar recursos para uma ID de localização específica da zona de coleta.
unique_zones = sorted(df["pickup_location_id"].unique())
zone_select = widgets.Dropdown(
    options=[str(z) for z in unique_zones[:30]],
    value=str(unique_zones[0]),
    description="Location ID:",
    disabled=False,
)


def plot_zone_demand(zone_id):
    zone_df = df[df["pickup_location_id"] == zone_id].sort_values(
        "event_timestamp"
    )
    if zone_df.empty:
        print("No records found for this location.")
        return

    # Plot pickups for the first week of the month
    sample_df = zone_df.head(168)  # 24 * 7
    plt.figure(figsize=(12, 4))
    plt.plot(
        sample_df["event_timestamp"],
        sample_df["pickup_count"],
        color="#e6550d",
        label=f"Zone {zone_id}",
    )
    plt.title(
        f"Hourly Taxi Pickups for Location ID {zone_id} (First 7 Days)",
        fontsize=13,
    )
    plt.xlabel("Timestamp", fontsize=11)
    plt.ylabel("Pickups", fontsize=11)
    plt.legend()
    plt.grid(True, alpha=0.3)
    plt.show()


# Precompute all outputs for the 30 zones client-side
plot_outputs = []
for zone_id in unique_zones[:30]:
    out = widgets.Output()
    with out:
        plot_zone_demand(zone_id)
    plot_outputs.append(out)

stack = widgets.Stack(children=plot_outputs, selected_index=0)
widgets.jslink((zone_select, "index"), (stack, "selected_index"))

widgets.VBox([zone_select, stack])